云计算在制造业落地:我踩过的坑,比教科书厚
上周去了一家做精密减速机的厂子。老板拉着我看他们新上的云平台——屏幕上花花绿绿的曲线,挺唬人。我问了一句:这些数据多久传到云上?他愣了两秒,说,大概……五秒?
我心里咯噔一下。
五秒。在冲压线上,五秒足够发生一次撞机。
这种场景我见得太多了。云计算这个词,在IT圈已经炒了十几年,可一旦放进车间,它根本不是一回事。工业场景里的云计算,你得同时搞定三件事:毫秒级的实时性、二十年不掉线的稳定性,还有——老板看得懂的投入产出比。
一、别把工业云当成“搬家的服务器”
很多工厂第一次接触云计算,都是被销售话术推着走的。“把MES搬到云上”“SaaS化订阅,不用买服务器了”。听着很美。
现实是——工业软件的架构,一大半还是十几年前的单体应用。你把它原样拎到公有云上,延迟先给你一巴掌。
我见过一个真实案例:某汽车零部件厂,把质检的机器视觉推理放到公有云。单件检测耗时从本地200毫秒飙到1.4秒。节拍直接崩了。后来怎么解决的?把推理模型下沉到产线旁的边缘节点,云上只做模型训练和版本分发。
这才是工业云的正确姿势:云负责“重”和“慢”的活,边缘负责“轻”和“快”的活。
云上跑什么?模型训练、历史数据挖掘、多工厂产能协同、供应链排产。边缘跑什么?PLC逻辑、实时控制、视觉推理、协议转换。
说实话,把IT那套“全部上云”的思路直接搬到车间,基本等于给自己挖坑。
问:那是不是意味着工业场景就不该用公有云了?
答:不是。要看数据类型和时效要求。设备OEE统计、能耗分析、质量追溯这类“事后分析”的活,公有云的弹性算力和存储成本优势非常明显。但涉及实时闭环控制的,别碰。判断标准很简单:这个动作延迟500毫秒,会不会造成设备损坏或人身伤害?会,就下沉到边缘。
 工厂车间边缘计算网关机柜部署实景
二、边缘计算不是云的备胎,是云的搭档
说个数字。❗ 在典型的离散制造车间,一台数控机床每秒产生的振动采样点,轻松上万。一个中型工厂,几百台设备,一天原始数据量能到TB级。
全传上去?带宽费先不谈,光是那点上传延迟和分析滞后,就够呛。
所以现在主流做法是三层架构:设备层 → 边缘层 → 云层。
边缘层干的事,说白了就是“过滤和瘦身”。原始的高频振动信号,本地做完FFT变换、特征提取,只把特征值和异常片段上传。数据量能压缩到原来的百分之几。
这里有个关键的东西——OPC UA和MQTT。前者解决的是设备语义互通,后者解决的是弱网环境下的可靠传输。这两个协议配合好,你的云平台才不至于变成一个“数据孤岛收集器”。
不过话说回来,边缘节点本身也是个麻烦事。散热、防尘、断电恢复、远程运维……工厂环境可比机房恶劣多了。我见过一个边缘盒子装在配电柜旁边,夏天柜内温度55℃,跑了一个月就死机,硬盘直接挂了。
所以选边缘硬件,别只看CPU和内存。工业级宽温、无风扇设计、看门狗、双电源冗余,这些才是保命的东西。
三、数字孪生:别被“三维大屏”骗了
现在工业云厂商最爱演示的就是数字孪生。一个3D的工厂模型,设备转动,数据跳动。老板一看,哇,好高级。
但真正有价值的数字孪生,不在那个渲染得漂亮的三维界面。在于——模型能不能反向指导生产。
举个例子。某注塑厂做了个模具的数字孪生体,把温度、压力、保压时间的曲线都建模了。上线半年后,他们用这个模型做了两件事:一是预测某个工艺参数组合下的产品缩水率,二是优化换模时的升温曲线,把开机废品率从7%压到2%出头。
这才叫数字孪生。它不是大屏,它是仿真加数据驱动的决策闭环。
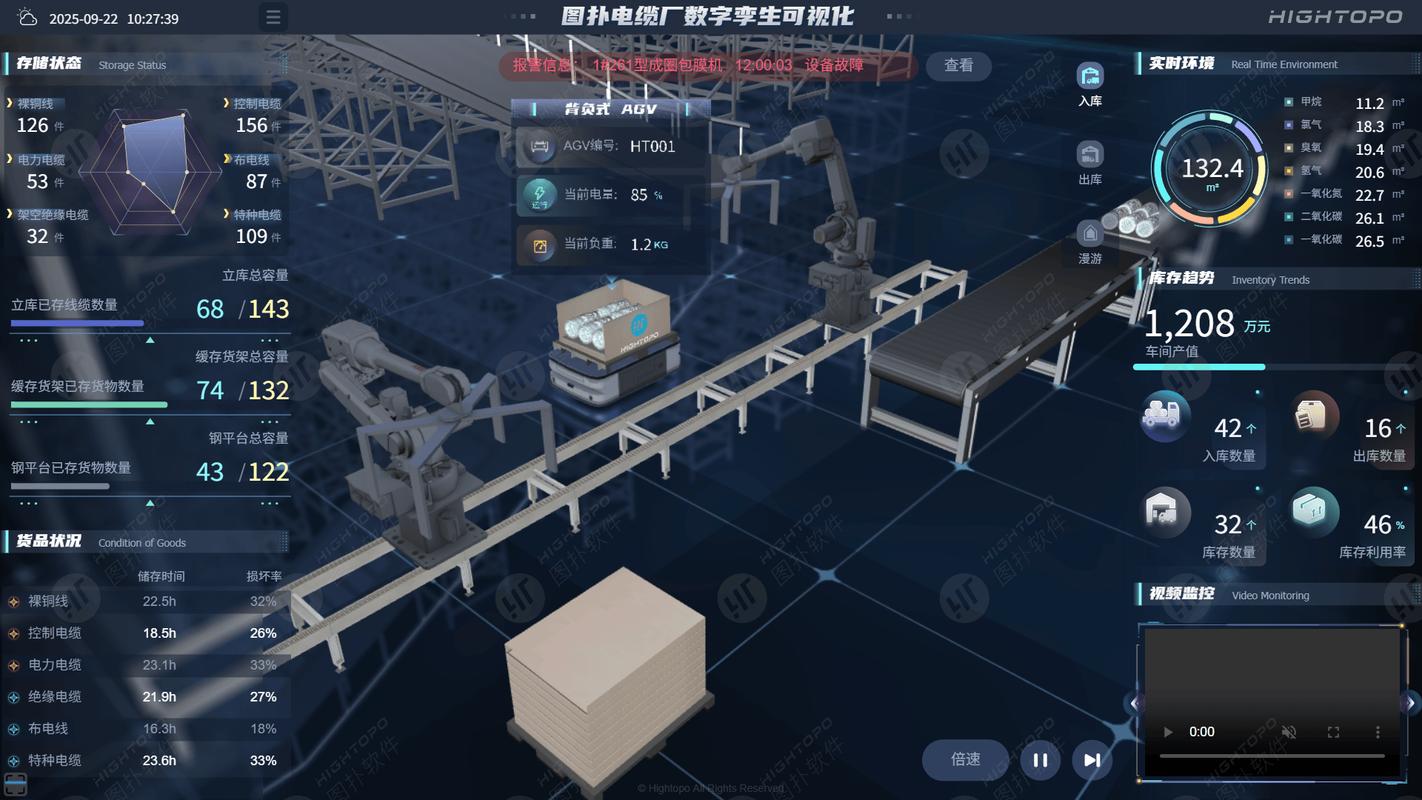 工业数字孪生生产线三维模型界面
而支撑这一切的底层,往往是时序数据库和数据湖的组合。时序库扛高频写入和降采样查询,数据湖存原始数据和半结构化日志,两者之间靠流处理管道打通。这套架构在云上跑,弹性扩缩容确实比自建机房省心。
问:中小企业预算有限,数字孪生是不是完全没戏?
答:有戏,但要从小切口进。别一上来就搞整厂三维建模,那是烧钱。先选一条瓶颈产线、一台关键设备,做“单机孪生”。用现成的云平台PaaS能力,加上轻量级仿真工具,十万级预算也能跑起来。关键是先跑通数据采集—建模—验证—优化的闭环,再谈扩展。
四、算笔账:云到底省不省钱
这个问题我被问过至少五十次。
答案是:看你的负载波动曲线。
如果你的工厂两班倒、三班倒,算力需求平稳,那自建机房加上虚拟化,单位成本可能更低。云的优势在于弹性——应对订单高峰、季节性的产能爬坡、临时的AI训练任务。
但工业场景有个特殊性:数据出厂的合规成本。有些行业,工艺参数属于核心资产,不允许放到公有云。这时候混合云或者私有云就是唯一选项。私有云的坑在运维——你得养一个懂Kubernetes、懂存储、懂网络的团队。中小企业养得起吗?
所以现在流行的是托管私有云,或者行业云。几个同产业链的企业共用一套云基础设施,数据隔离,成本分摊。这个模式在长三角的模具产业集群里,已经跑出一些案例了。
💡 一句大实话:别为了“上云”而上云。先问清楚自己三个问题——数据时效要求多高?数据能不能出厂?算力需求波动多大?答案不同,路径完全不同。
五、云原生,工业软件正在补课
最后聊点技术趋势。
传统的工业软件——MES、SCADA、APS——基本都是单体架构,Windows Server上跑着,升级要停机,扩容要买机器。
这几年明显的变化是容器化和微服务化。把排产算法拆成独立服务,把数据采集拆成独立服务,各自独立部署、独立扩缩。好处显而易见:某个模块崩了,不至于整条线停摆。
但改造的代价也大。老代码里的状态耦合、数据库直连、硬编码的IP地址……拆起来痛苦得很。我见过一个团队改MES,改了两年,还没完全拆干净。
Serverless在工业场景的落地就更慢了。冷启动延迟、长连接保持、本地文件读写……这些在互联网场景能绕过去的坑,在工业现场全是硬约束。不过在一些离线批处理场景——比如夜间的报表生成、历史数据归档——已经有人在用了。
 机械臂自动化产线云平台实时数据监控看板
说句可能不讨喜的话:工业云的下半场,不是比谁的云平台功能多,而是比谁更懂车间。懂工艺、懂设备、懂那些藏在老师傅脑子里的经验。技术只是容器,装进去的东西才是价值。
行,先写到这。后面有空再聊聊多云管理和云上安全的那些事——那又是另一个深坑了。