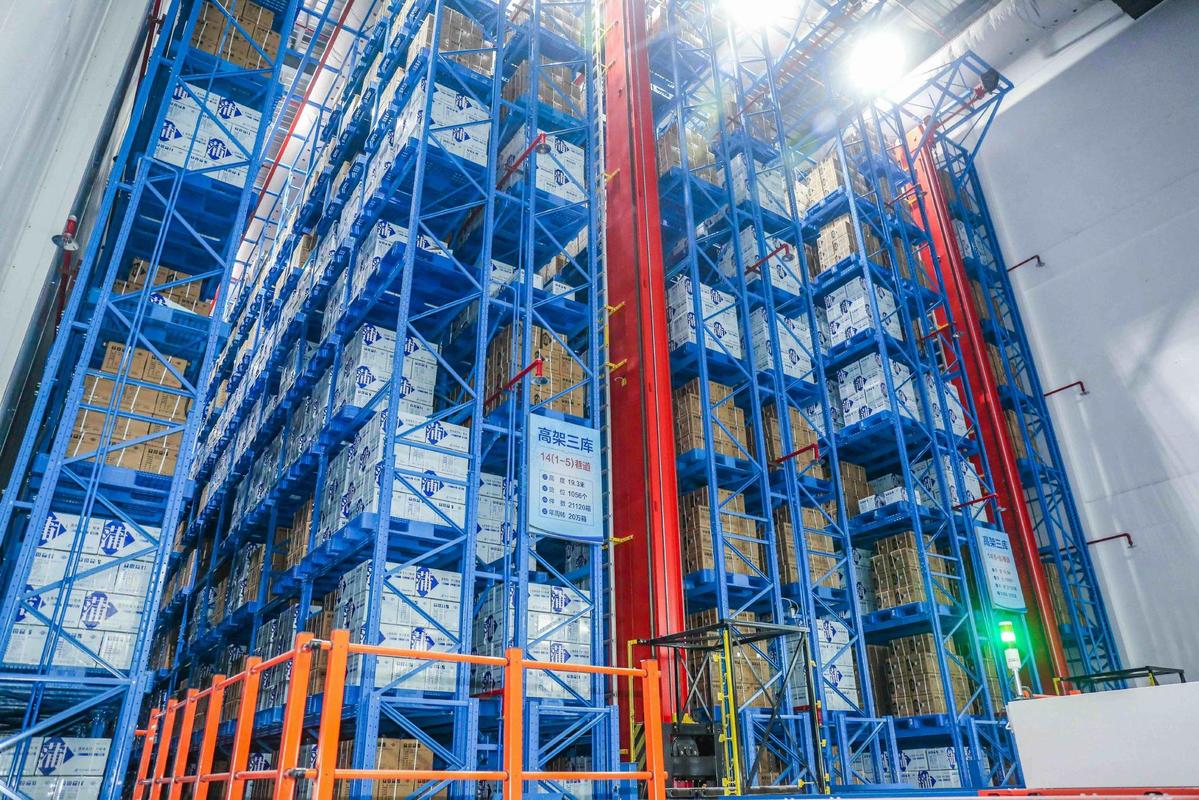
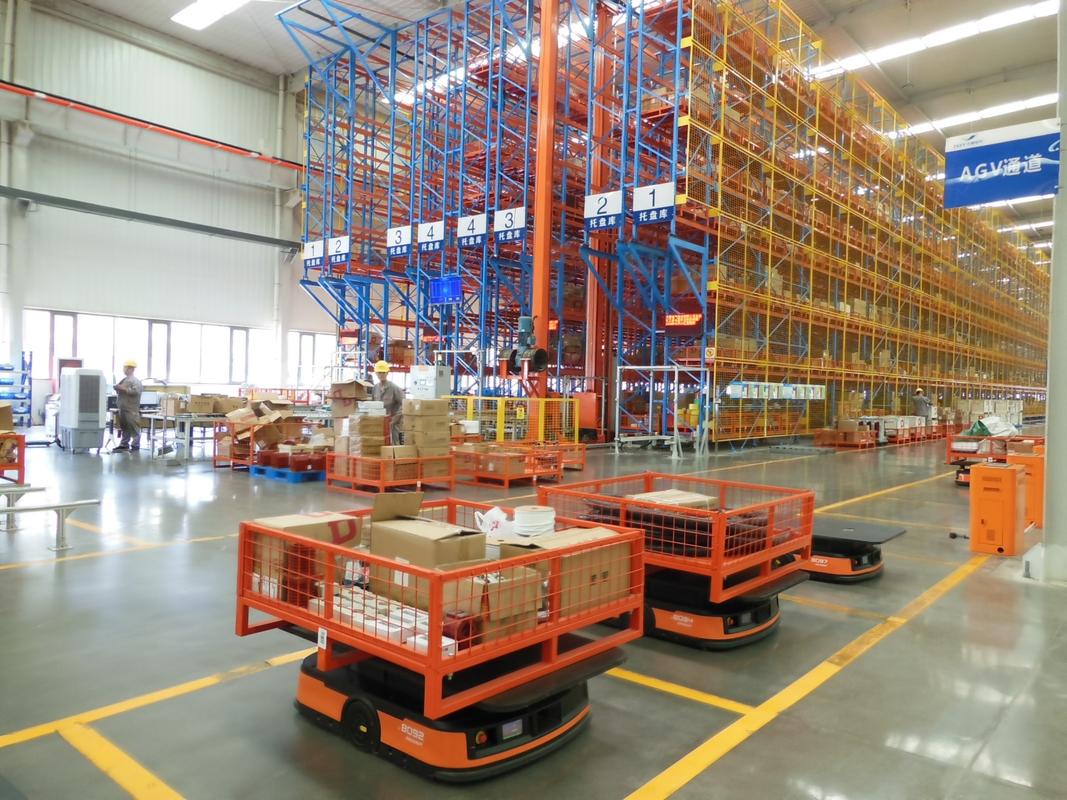
产线旁边那台工控机,其实早就在干边缘计算的活了
说实话,我第一次听到边缘计算这个词的时候,心里想的是——这不就是工控机换了件马甲嘛?
2018年前后,这词突然就火了。供应商、集成商、各种行业展会,铺天盖地。什么云边协同、边云一体、算力下沉……听得人脑袋疼。
但你把那些花里胡哨的PPT撕掉,内核其实特别朴素。
数据在哪儿产生,就在哪儿处理。就这一句话。
工厂里每台CNC、每个PLC、每个传感器,每秒都在往外吐数据。以前怎么做?统统打包,顺着网线或者4G/5G扔到千里之外的云服务器上,算完了再把指令传回来。听着挺美好对吧。
问题来了。
延迟。你一条高速冲压线,每分钟冲次几十下,冲头下压的窗口可能就几十毫秒。你指望信号绕地球半圈再回来?产线早废了。
再看个更现实的。视觉质检。一条手机外壳喷涂线,12个高清工业相机同时拍,每个每秒30帧。什么数据量?单条产线一天产出的原始图像,轻松到TB级。全传上去?带宽费用先不提,存储成本就够你喝一壶。
所以边缘计算解决的第一个问题,从来就不是什么高大上的概念,说白了就四个字:
就近处理。

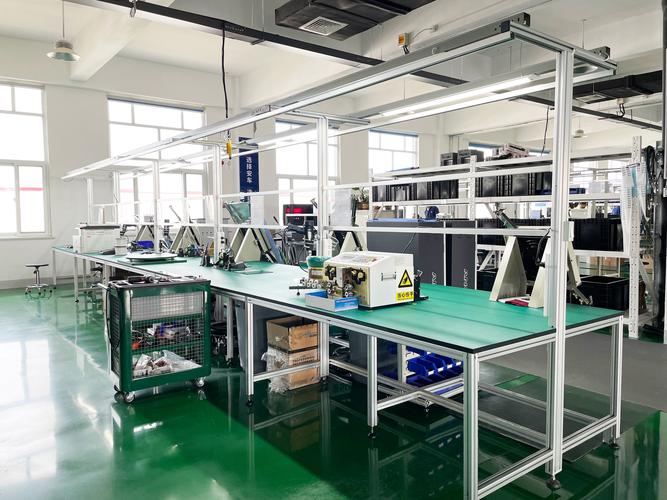
工业产线边缘计算网关机柜实拍图
算力放多少,这是个学问
行业里有个特别容易踩的坑。就是把边缘节点当成一个小号数据中心,什么都往里塞。
我见过一个项目,某汽车零部件厂,一上来就说要在每个车间部署一套GPU服务器,做实时AI推理。结果呢?设备买回来了,散热没做,车间温度四十多度,GPU三天两头降频。再加上粉尘、震动……
半年后,一半的机器处于半瘫状态。
❗ 边缘计算不是把机房搬到车间,它其实是
在恶劣环境里做减法的艺术。
正确的思路应该反过来:
- 需要毫秒级响应的,比如运动控制、安全联锁 → 放现场,用PLC或专用控制器,别用通用服务器
- 需要秒级到分钟级的,比如视觉质检、异常检测 → 放车间边缘服务器,跑轻量化AI模型
- 需要小时级以上的,比如排程优化、全厂能效分析 → 老老实实上云
分层逻辑比一味追求“边缘化”靠谱得多。
边缘节点到底谁来维护?这笔账得先算清
很多人会忽略边缘设备的
运维成本。云端出问题,运维工程师坐办公室就解决了。边缘节点出问题呢?你得派个人,戴上安全帽,钻进产线,在轰鸣声里排查故障。中间的停工损失,算过没有?
所以边缘节点必须是免维护或者远程可维护的设计。不然就是给自己挖坑。
真实案例:一条产线能省下多少
说个我去年跟过的项目。
华东一家做精密轴承的厂,产线上48台磨床。原来每台设备的振动、温度、主轴电流数据全都上传到一个云平台做健康度分析。每台每秒采样2000个点,48台就是96000点/秒的原始数据流。
每个月专线加云资源费用,接近六位数。
后来改成边缘计算架构。车间部署两台本地边缘服务器,先做数据预处理和特征提取。原来96000点/秒,经过边缘端FFT变换、特征压缩之后,上云的数据量降到了原来的
不到百分之三。
省钱是一方面。更关键的是响应速度。原来从采集到报警,链路走完要2到3秒。现在本地延迟稳定在50毫秒以内。
50毫秒能干吗?够在主轴轴承出现早期磨损特征的时候,提前把转速降下来,避免一次几十万的停机事故。
问:那边缘服务器挂了怎么办,数据会不会丢?
答:这是很多工厂最担心的一点。实际部署时,边缘节点通常要做本地缓存,一般至少保留24到72小时原始数据。同时配双机热备或者至少做RAID。断网了,本地继续跑,网络恢复再补传。真正的风险不在硬件本身,而在于你有没有设置合理的
断网续传策略和故障切换逻辑。这一块,方案商必须给出明确的SLA承诺,白纸黑字写进合同。
工业机器人产线数据采集边缘计算应用场景
协议这道坎,绕不过去
协议这道坎,绕不过去
讲边缘计算,很多人喜欢讲算力、讲AI、讲5G,绝口不提最痛的一点。
工业协议。
你走进任何一家有点年头的工厂,能看到什么?西门子的Profibus、三菱的CC-Link、罗克韦尔的EtherNet/IP、欧姆龙的EtherCAT,可能还有一堆Modbus RTU,串口线拉得到处都是。各家厂商各玩各的,谁也不服谁。
边缘计算设备要做的第一件事,实际上是
协议转换和数据采集。
这一块的难度,比想象的大。很多号称支持主流工业协议的边缘网关,实际部署遇到非标设备、老设备、私有协议,直接就歇菜。
💡 我的建议很简单:选边缘网关,别信规格书上的协议列表。直接让厂商技术上门,到现场,现场调试。调通了再签合同。
还有,OPC UA这几年推得比较猛,新建项目会拿它当统一数据层。但存量设备怎么办?加协议转换模块。这笔钱,预算里一定要算进去。
问:边缘计算和工业互联网平台是不是一回事?
答:不是。这俩经常被搞混。工业互联网平台通常指云端PaaS层,管数据汇聚、分析、应用开发。边缘计算是靠近设备那一层,管实时采集、预处理、本地决策。上下游关系,不是替代关系。健康架构一定是
云边端协同——端侧负责执行,边侧负责实时,云侧负责全局优化。少哪一层都跑不顺。
给正在选型的工程师几句话
给正在选型的工程师几句话
如果你现在正在做边缘计算的方案,几个实在的建议:
第一,先想清楚要解决什么问题。是延迟?是带宽成本?是数据合规?还是本地自治能力?不同问题,架构完全不一样。
第二,别被算力数字忽悠。TOPS、FLOPS这些指标,在工业场景里参考价值有限。真正重要的是你的模型在目标硬件上的实测推理延迟,以及长时间运行的稳定性。
第三,散热和防护等级比CPU型号重要。IP65、宽温设计、无风扇方案,在车间里是硬需求。
第四,先做试点。别一上来全厂铺开。选一条产线,跑三个月,把坑踩完,再复制。
边缘计算这件事,说到底没那么玄。它就是让算力离数据近一点,让决策快一点,让成本低一点。
它解决不了所有问题。搞不好还会带来新的运维麻烦。
但在越来越多的工业场景里,它确实是那个更合理的选择。
 工业产线边缘计算网关机柜实拍图
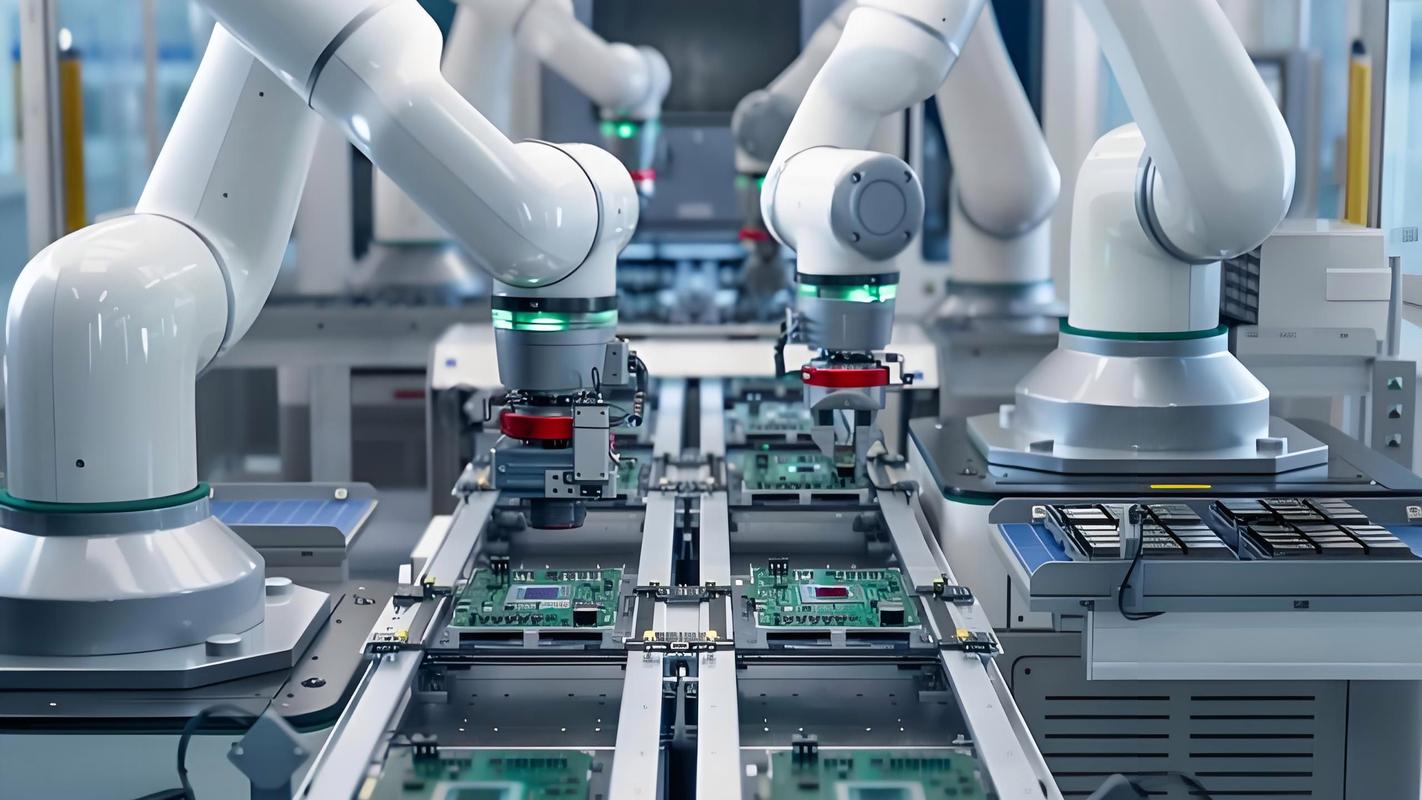 工业机器人产线数据采集边缘计算应用场景
 协议这道坎,绕不过去
讲边缘计算,很多人喜欢讲算力、讲AI、讲5G,绝口不提最痛的一点。
工业协议。
你走进任何一家有点年头的工厂,能看到什么?西门子的Profibus、三菱的CC-Link、罗克韦尔的EtherNet/IP、欧姆龙的EtherCAT,可能还有一堆Modbus RTU,串口线拉得到处都是。各家厂商各玩各的,谁也不服谁。
边缘计算设备要做的第一件事,实际上是协议转换和数据采集。
这一块的难度,比想象的大。很多号称支持主流工业协议的边缘网关,实际部署遇到非标设备、老设备、私有协议,直接就歇菜。
💡 我的建议很简单:选边缘网关,别信规格书上的协议列表。直接让厂商技术上门,到现场,现场调试。调通了再签合同。
还有,OPC UA这几年推得比较猛,新建项目会拿它当统一数据层。但存量设备怎么办?加协议转换模块。这笔钱,预算里一定要算进去。
问:边缘计算和工业互联网平台是不是一回事?
答:不是。这俩经常被搞混。工业互联网平台通常指云端PaaS层,管数据汇聚、分析、应用开发。边缘计算是靠近设备那一层,管实时采集、预处理、本地决策。上下游关系,不是替代关系。健康架构一定是云边端协同——端侧负责执行,边侧负责实时,云侧负责全局优化。少哪一层都跑不顺。
 给正在选型的工程师几句话
如果你现在正在做边缘计算的方案,几个实在的建议:
第一,先想清楚要解决什么问题。是延迟?是带宽成本?是数据合规?还是本地自治能力?不同问题,架构完全不一样。
第二,别被算力数字忽悠。TOPS、FLOPS这些指标,在工业场景里参考价值有限。真正重要的是你的模型在目标硬件上的实测推理延迟,以及长时间运行的稳定性。
第三,散热和防护等级比CPU型号重要。IP65、宽温设计、无风扇方案,在车间里是硬需求。
第四,先做试点。别一上来全厂铺开。选一条产线,跑三个月,把坑踩完,再复制。
边缘计算这件事,说到底没那么玄。它就是让算力离数据近一点,让决策快一点,让成本低一点。
它解决不了所有问题。搞不好还会带来新的运维麻烦。
但在越来越多的工业场景里,它确实是那个更合理的选择。