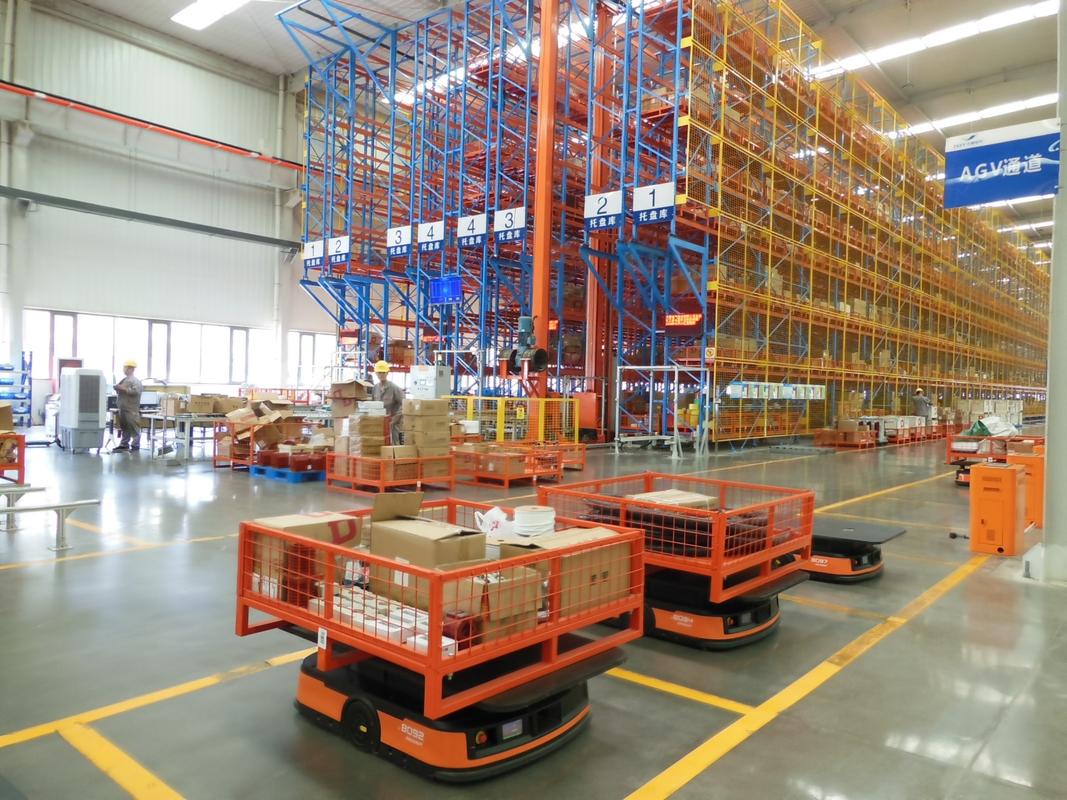
工业大数据实战:从设备振动到停机预警,中间隔着什么?
先说个真事。去年冬天,华东一家汽车零部件厂的630吨冲压机主轴承抱死,停机72小时,直接损失逼近两百万。事后翻数据,振动传感器其实提前11天就报警了。
没人看。
报警信息躺在SCADA系统的历史库角落里,安安静静。操作工习惯了满屏的黄色告警——“反正每次都这样,过会儿自己就好了”。这就是工业大数据最尴尬的现状:数据不缺,缺的是让数据说话的那根神经。
数据采集这件事,脏起来超出你想象
很多老板以为上了传感器就等于有了大数据。
天真。
我见过一个项目,振动测点装在轴承座侧面,离激振源十万八千里,采样率设了1kHz——滚动轴承早期故障的特征频率往往在5kHz以上,你连边都摸不着。这种数据喂给再牛的算法也是垃圾。真的,垃圾进垃圾出,这句话在工业场景里比在互联网场景里还要残酷十倍。
工业数据的“脏”是全方位的:
- 时间戳不同步:PLC时钟和服务器时钟差个几十秒是常事,多源数据对齐就成了灾难
- 量纲混乱:同一类设备,A车间用mm/s,B车间用μm,合并分析前先得洗一遍
- 缺失值有含义:传感器掉线导致的空值,和设备停机导致的空值,意义完全不同,你用均值填充?等着模型学歪吧
- 工况漂移:夏天和冬天同一台设备的基线振动幅值能差15%,你不做工况归一化,模型冬天疯狂误报,夏天彻底哑巴
 工业车间电机振动传感器安装现场实拍图
❗说句不中听的。很多工厂花几十万买的“预测性维护系统”,本质上就是个阈值报警器——超过某个固定值就弹窗。这玩意儿跟二十年前的继电保护有什么区别?换个壳子就敢卖十万,属实离谱。
特征工程:这才是工业大数据的命门
互联网大数据的玩法是“喂原始数据给深度模型,让它自己学”。工业场景里,这套路经常玩不转。
为什么?
样本量不够。一台关键设备一年可能就故障一两次,你上哪弄百万级标注样本去?所以工业界至今还在大量依赖时域统计量(RMS、峭度、峰值因子)、频域特征(特征频率幅值、边频带能量)和时频域分析(小波包分解、短时傅里叶变换)。
这些东西,说实话,不性感。但管用。
就拿滚动轴承来说——外圈故障、内圈故障、滚动体故障,它们在包络谱上的特征频率是算得出来的,跟你轴承的几何参数和转速有关。你把转速信号和振动信号一结合,阶次分析一做,故障定位的准确率蹭蹭往上走。这种事,光靠端到端深度学习硬怼,数据量根本不够。
💡我的建议是:机理先行,数据补充。别一上来就搞什么Transformer、什么注意力机制。先把FFT做对,先把包络谱解调搞明白,先把工况参数归一化做好。这些基本功扎实了,一个简单的随机森林都能跑出不错的效果。
问:我们厂都是十几年的老设备,没有预留传感器接口,也没有历史故障标签,这种情况还能做大数据分析吗?
答:能,但路子得走对。第一步不是上算法,是补数据基础设施——加装振动传感器(建议加速度计,灵敏度100mV/g起步)、电流互感器(非侵入式安装,不动机柜),先把数据采上来。没有标签怎么办?两个办法:一是找设备厂商要同类设备的故障案例,做迁移学习;二是用无监督方法先做异常检测,积累一段时间后再让老师傅帮忙标注。别指望一上来就搞有监督分类,那不现实。
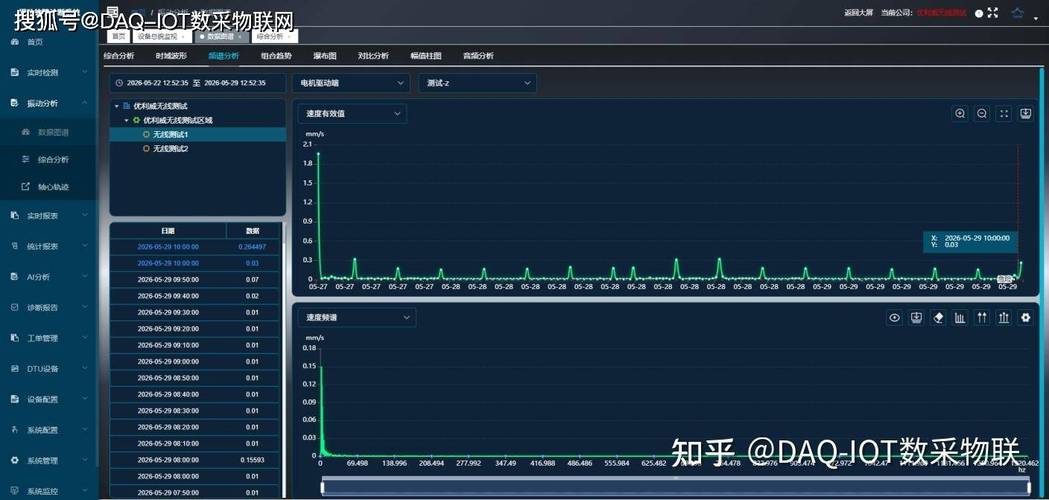 工厂设备预测性维护振动频谱分析界面截图
数字孪生和边缘计算,别被概念带偏了
 数字孪生和边缘计算,别被概念带偏了
现在展会上一堆供应商张口闭口“数字孪生”。你问他孪生什么了?他给你放一段三维动画——齿轮转啊转,颜色变红表示故障。
这不叫数字孪生。这叫三维可视化。
真正的数字孪生在工业场景里,核心是降阶模型(ROM)加实时数据同化。说白了,你得有一个能跟着实际设备状态动态更新的物理模型或数据驱动模型,它能回答“如果我把负载从60%提到85%,轴承温度会在多久后超过警戒线”这种问题。不是画个3D图就完事了。
不过话说回来,数字孪生目前真正落地的场景还是集中在高价值资产上——航空发动机、燃气轮机、风电主齿轮箱。一台几十万的普通机床,搞数字孪生的投入产出比确实不划算,用简单的趋势分析和阈值报警就够用了。
边缘计算倒是值得多说两句。很多工厂的数据采集频率高了之后,全传云端根本扛不住——一个车间200个测点,每个测点每秒2万采样点,你自己算算带宽。所以现在主流做法是边缘侧做特征提取和初步诊断,只把特征值和告警事件传上去。这样既省带宽,又降低了响应延迟。
有个做风电的客户跟我算过账:边缘侧部署后,数据传输量降了97%,但诊断准确率反而提高了——因为边缘侧可以跑更高频率的原始数据分析,不受传输瓶颈限制。
问:边缘计算和云端分析,到底怎么分工才合理?
答:一个实用的原则——跟实时性有关的放边缘,跟全局优化有关的放云端。比如振动超限停机判断、温度趋势异常检测,这些必须在边缘侧毫秒级完成;而多台设备的横向对比、设备群健康度排名、备件需求预测,这些放云端更合适。中间用MQTT协议传特征值和事件就行,别传原始波形。另外提醒一句,边缘设备的算力选型别抠门,至少留30%的余量,否则后面加算法你就等着哭吧。
最后聊点实在的:钱花在哪儿
 最后聊点实在的:钱花在哪儿
如果你们厂年产值在5亿以下,设备数量不超过200台,我的建议很直接:
- 别买大平台。先用好身边的工具——很多PLC自带的趋势记录功能,配合简单的统计分析,就能解决60%的问题
- 先做关键设备。把所有设备按停机影响程度排个序,前20%的设备优先上监测,投入产出比最高
- 培养一个懂工艺又懂数据的人。这种人比任何系统都值钱。真的。算法能买,业务理解买不来
- 别追求一步到位。从阈值报警到趋势预警,再到故障分类,一步一步来。每一步都能产生实际价值,再往下一步走
工业大数据这事,说到底不是技术问题,是愿不愿意蹲下来把脏活累活干好的问题。传感器装对位置,数据洗干净,特征算准确——这三件事做好了,你甚至不需要什么深度学习,一个逻辑回归都能给你省下大几百万。
传感器装不对,数据不洗,上来就搞大模型……那钱花出去,连个响都听不见。