机器学习进产线:一个制造业老兵的五年踩坑实录
去年冬天,在苏州一家做精密齿轮的厂子里,我亲眼看着一条上了“AI质检”的产线被工人手动关掉。原因?模型把合格品判成了废品,一小时误杀了三百多件。车间主任骂了一句粗话,扭头就走。那套系统花了小两百万,最后变成了角落里吃灰的工控机。
这事儿我见得太多。机器学习这四个字,在互联网圈早就不是新鲜词了,可一旦落到工业现场,画风突变。这里没有海量用户行为数据,没有可以快速试错的A/B测试,有的只是铁屑、油污、震动,和一条绝对不能停的产线。机器学习在工业场景的落地难度,至少是消费互联网的三倍以上。
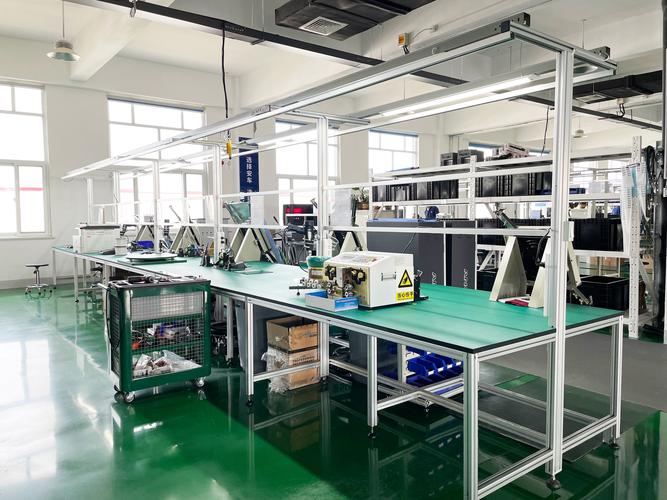
 制造业车间数控机床加工现场实景图
工业数据和互联网数据,压根不是一回事
 工业数据和互联网数据,压根不是一回事
很多从大厂跳过来的算法工程师,最不适应的一点就是——工业数据太少了。少到让人抓狂。
你可能会说,一条24小时运转的产线,传感器每秒采一次数据,一天就是八万多条。可问题是,这些数据全是“正常”的。设备没坏的时候,数据平平无奇;设备坏了那一瞬间,异常样本可能只有几十条。想用这种极度不平衡的数据训练故障预测模型?抱歉,够呛。
更麻烦的是标注。互联网图片,找个众包平台几毛钱标一张。工业场景呢?一条产线一天的振动数据,要让干了二十年的老师傅来标“这段有问题,那段正常”——标完半个月过去了……
我遇到过最离谱的情况:一家做注塑的厂子,换了新模具之后,之前积累了三年的数据全部作废。工况变了,数据分布完全对不上。💡 这就是工业机器学习的残酷之处——模型不是一劳永逸的,它需要持续维护、持续迭代。
问:我们厂数据量不大,是不是就做不了机器学习?
答:不一定。数据量少不等于做不了,关键看你怎么定义问题。如果目标是设备故障预测,那确实需要足够多的故障样本。但如果做的是异常检测——也就是只要找出和正常状态不一样的情况——小样本反而有优势。工业场景里,One-Class SVM、自编码器这类方法在数据不平衡的情况下,往往比传统分类模型更稳。重点是选对问题,别一上来就想着搞深度学习。
模型精度98%?先别高兴太早
我特别怕听到一句话:“我们模型准确率98%。”
实验室里跑出来的98%,和产线上的98%,完全不是一回事。实验室数据是清洗过的、标注好的、分布均匀的。产线上呢?油污糊住了摄像头、物料批次换了、环境温度变了——任何一个变量都能让模型瞬间崩盘。
工业机器学习真正难的不是训练模型,是把模型部署到产线上并且稳住。
部署这件事,坑太多了。你得考虑边缘计算设备的算力够不够,推理延迟能不能压到毫秒级,模型更新的时候产线要不要停——这些在论文里从来不会写。说实话,我见过太多项目死在最后一公里上。
 工业边缘计算网关设备部署在产线控制柜内照片
问:模型在实验室效果很好,一到现场就不行,怎么办?
答:太常见了。我的经验是,先别急着调模型,先查数据管道。很多时候不是模型的问题,是现场采集的数据和训练数据的预处理方式不一致。比如训练时振动信号采样率是10kHz,现场部署时因为采集卡配置问题变成了8kHz,特征分布直接就偏了。还有一个容易忽略的点——时间同步。多传感器融合的场景下,不同传感器的时钟差个几十毫秒,做特征工程的时候相关性全乱了。先把工程层面的问题排查一遍,再回头看模型。
关于投入产出,说点实在的
老板们最关心的永远是三个字:值不值。
我见过的成功案例,无一例外都是在特定场景下做到了极致的降本增效,而不是搞一个大而全的“智能制造平台”。有个做轴承的客户,就在一道研磨工序上做了机器学习优化——通过调整磨削参数来降低废品率。就这一件事,一年省了四百多万。另一个做光伏的,用视觉检测替代了三个质检员,回收周期不到八个月。
反过来,那些一上来就说要做“全厂智能大脑”的项目,基本都黄了。✅ 工业机器学习的正确姿势是:单点突破、快速验证、逐步扩展。别贪大。
还有人才的问题。你不需要养一个二十人的算法团队。现在很多工业软件厂商已经提供了预训练模型和低代码训练平台,关键是找到一个既懂工艺又懂数据的人来做“翻译”——把车间里的问题翻译成机器学习能解决的任务。这种人比纯粹的算法工程师难找多了。
最后说句不中听的:机器学习不是万能药。有些问题用传统的统计过程控制就能解决,非要上AI干嘛?❗ 工厂里最怕的就是为了AI而AI。技术在变,产线的逻辑没变——稳定压倒一切。