边缘计算在工业现场:别再把所有数据都往云上送了
边缘计算在工业现场:别再把所有数据都往云上送了
去年冬天,在常州一家做精密减速器的厂里,我盯着他们的数据采集方案看了半天。一个车间,三百多个振动传感器,外加几十台机床的电流、温度、转速信号,全量打包,通过工业交换机推上公有云。
带宽账单一个月六位数。更离谱的是,一台磨齿机的主轴轴承已经开始异响,云端的报警要等到数据攒够一个批次、模型跑完才下发。刀已经划过去了。
工程师的原话我记到现在:「这套系统离线看报表挺好,真出事它比我还慢。」
对,问题就在这儿。不是云不行,是把该在车间里干的事,全甩给了两千公里外的机房。
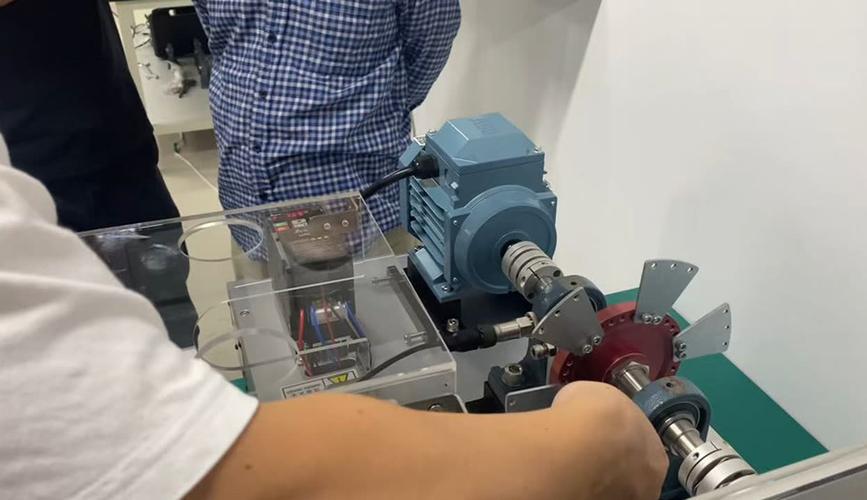
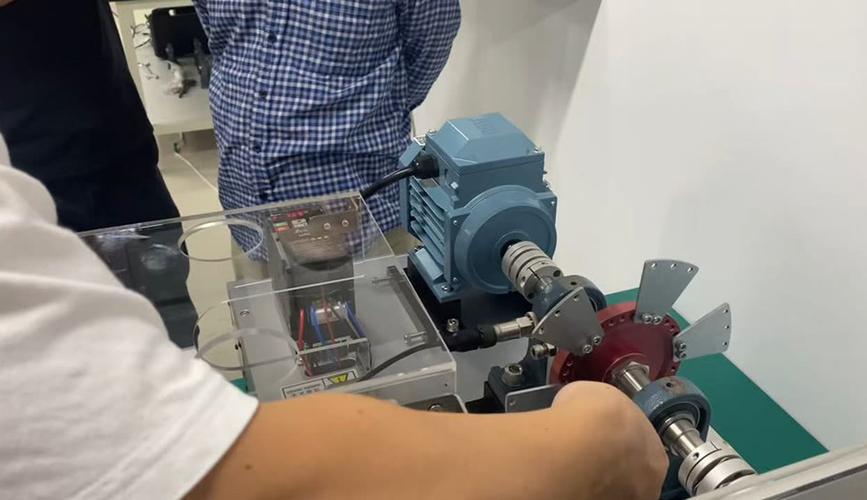
 工厂车间边缘计算网关机柜现场部署实景
工业机器视觉边缘计算质检产线相机检测
工业边缘计算云边协同架构拓扑示意图
 工厂车间边缘计算网关机柜现场部署实景
先说清楚:边缘计算不是把服务器搬到车间角落
很多人第一次听这个词,脑子里浮现的是「在车间放一台工控机」。这个理解,只说对了一半。 工控机只是壳子。真正的边缘计算,指的是在靠近数据源的位置完成采集、协议解析、实时判断和本地决策,只把有价值的结果或者特征数据向上传。它解决的是三件事:延迟、带宽、数据主权。 拿一个典型的注塑车间举例。一台机几十个工艺参数,模温、保压压力、熔胶位置,采集频率动辄100Hz。全量上传?数据量吓人,而且99%是正常的。边缘节点本地先跑一个轻量模型,只在偏离基线超过阈值的时候,把前后10秒的原始波形打上时间戳上传。数据量能砍掉九成以上。 技术上怎么落地?三层就够:- 协议层:把 Modbus、PROFINET、EtherCAT、OPC UA 这些五花八门的现场总线统一成一种数据格式。这一步最脏最累,也最不能省。
- 计算层:容器化的推理服务加规则引擎。K3s 比完整 K8s 更适合现场,几十MB内存就能跑起来。
- 协同层:和云端做模型下发、数据回传、策略同步。边缘负责快,云负责聪明。
哪些场景真跑起来了
练了这么多年,能真正见到回本的场景其实不多。挑几个说。预测性维护
振动、电流、温度,三路信号在边缘侧做特征提取,FFT、包络谱、均方根值这些。边缘节点自己能判「轴承外圈故障早期」,也可以把特征值上传云端做趋势比对。关键是报警发生在毫秒级,不是分钟级。主轴、风机、液压泵这类关键设备最划算。机器视觉质检
这个是真刚需。一条产线30帧每秒的相机,图像全传云端,带宽直接爆炸。边缘盒子本地推理,只上传NG图像和判定结果,延迟从几百毫秒压到二十毫秒以内。铸件气孔、焊缝缺陷、表面划痕,都在这上面跑。 工业机器视觉边缘计算质检产线相机检测
TSN 与实时运动控制
这一块门槛最高。多轴同步、电子凸轮、龙门结构的协同,抖动要求是微秒级。传统以太网和普通边缘盒子根本顶不住。要上 TSN(时间敏感网络),交换机、网卡、时钟同步全得配套。说白了,这属于确定性网络的范畴,是边缘计算里最硬的一块骨头。能耗与碳排监测
相对简单,回报也快。电表、气表、水表数据在边缘聚合,按班次、按设备、按工单归集。很多厂光靠这个就发现了空压机泄漏和夜间闲置设备,一年省下的电费够覆盖硬件投入。问:边缘节点到底要多大算力?要不要上 GPU?
答:看场景,别一刀切。纯采集和协议转换,ARM 架构的工控网关(两核四线程、2G 内存)完全够用,功耗低还无风扇。要做振动频谱分析、简单异常检测,x86 边缘盒子加个入门级 CPU 就能跑。 只有机器视觉、深度学习推理这类,才需要 NVIDIA 的 Jetson 系列或者带独立显卡的边缘服务器。但记住一件事——现场机柜的散热能力,往往比算力更容易成为瓶颈。车间夏天45度,你的边缘服务器风扇堵了灰,跑三天就降频。这个坑我踩过,赔进去两台设备。 还有个务实的建议:先在一条产线做单点验证,别一上来就铺全厂。跑通一个场景,算清楚投入产出比,再谈扩展。问:老设备没有网口,也没有 OPC UA,怎么接?
答:这是国内工厂最常见的现实。两种路子。 一是加装传感器旁路采集,不动原有控制系统。电流互感器套在电机线缆上,振动传感器磁吸在轴承座上,温度贴片粘在关键点位。这种做法不影响原设备保修,风险最低,老旧机床尤其适合。 二是走原有总线的旁路监听,比如在 RS485 上并一个 Modbus 从站监听,或者西门子 PLC 通过 S7 协议读取。这个要懂 PLC 的程序结构和地址映射,得让原厂或者懂行的人来做。 两条路可以并行。关键原则:边缘计算的第一要务是「不干扰生产」,任何可能影响控制回路稳定性的操作都要慎之又慎。生产线的确定性,比数据完整性重要一万倍。踩坑清单,能省你半年时间
说几个真想说的话。 网络隔离别偷懒。边缘节点直连生产网,一旦中毒或者广播风暴,整条线停给你看。用工业防火墙、VLAN 隔离,或者干脆做单向数据采集。 时钟同步是隐形杀手。多源数据要关联分析,时间戳必须对齐。上 NTP 或者 PTP,谢绝「差不多就行」。 别迷信容器编排的复杂度。一个车间就三五个边缘节点,搞一整套 K8s 集群加 CI/CD 流水线,运维成本远超收益。K3s、Docker Compose,甚至裸机跑 systemd 服务,很多时候更实在。 数据格式现在就定。不然后面每接一种新设备就要改一次代码,越接越乱,最后没人敢动。 现场要能远程运维。车间的边缘节点分散在十几个厂房,你不可能天天跑现场。VPN 隧道、远程日志、OTA 升级,这些在方案设计阶段就要留出来。 工业边缘计算云边协同架构拓扑示意图