数字孪生落地制造业:别急着建模,先把数据这根管子接通
去年冬天,我在一家做减速机的厂子待了三天。车间主任特别热情,拉着我看他刚验收的“数字孪生大屏”。三维模型转得很顺,齿轮咬合动画一丝不苟,连螺栓都一颗不差。我问了一句:这台机器现在主轴温度多少?
他愣了两秒。屏幕上跳出来的数字,是三天前工艺员手工填进 Excel 的。
这就是当下制造业数字孪生最真实的处境。模型很漂亮,数据在裸奔。
一、先把数据这根管子接通,再谈建模
我做过统计。一个中等规模的机加工车间,数字孪生项目里大约七成的时间花在数据接入上,剩下的三成才是建模和可视化。很多人不信。你去现场看一眼就明白了。
一台 2015 年的加工中心,控制系统是发那科。旁边那台是西门子 840D。再过去两台国产系统。三套协议,三种数据字典,同一个“主轴转速”字段,单位一个写 rpm、一个写 r/min、还有一个干脆没单位。
这时候你要做的是统一语义层,不是买三套驱动。
- 协议侧:OPC UA 现在是主流选择,Modbus TCP 仍是存量设备的救命稻草。别指望老设备都支持 UA,加边缘网关做协议转换。
- 频率侧:这是被低估的坑。温度、压力这类缓变量,1Hz 甚至 0.1Hz 足够。但振动信号,你至少得给到 20kHz 才有分析价值。很多项目为了省成本,用普通 PLC 的扫描周期去采振动——采回来的东西,说实话,不如不采。
- 时间侧:❗时钟同步是隐形杀手。PLC、视觉相机、扫码枪、MES 各自的时钟差个几百毫秒,你在孪生体里做因果分析时,会得到完全错误的结论。上 NTP 或者 PTP,别省这个事。
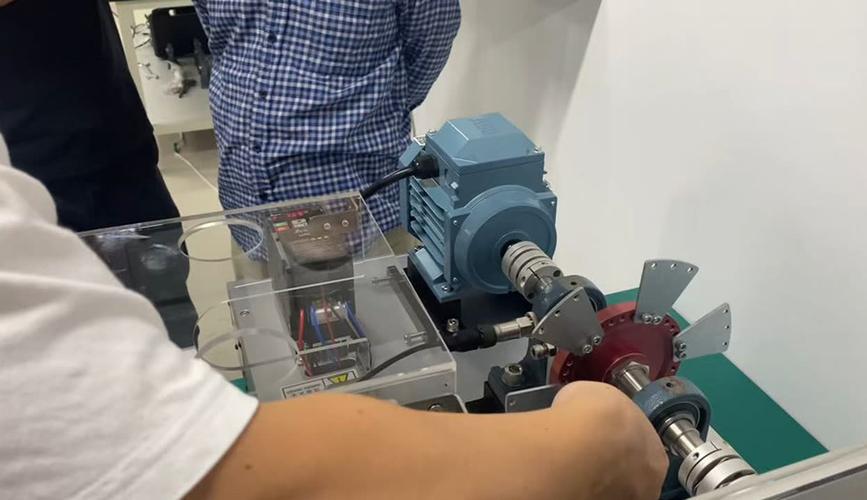
 机加工车间数控机床数据采集边缘网关接线实拍
二、几何模型和物理模型,根本不是一回事
行业里有个误区:觉得把 CAD 模型导进引擎,就“孪生”了。
不是的。那叫三维可视化。
几何保真是给谁看的?给人看的。给运维看一眼设备位姿,给参观的领导看一眼产线全貌。这个层面,模型轻量化比精度重要得多。我见过一个项目,把 20 个 G 的原始 CAD 直接怼进 Unity,浏览器加载了四分钟然后崩了。正确的做法是降面、抽壳、转 glTF 或 JT,把内部不可见的结构全删掉。十万面以内,一个中等复杂度的设备就够看了。
物理保真才是难的那部分。它要回答的是“如果我这么做,会发生什么”。
举个例子。主轴连续跑八小时,热变形会让刀尖位置偏移几十微米。这个偏移量,靠几何模型永远算不出来。你得有热-结构耦合的机理模型,或者用降阶模型 ROM 把有限元压成毫秒级可解的形式,再或者,用实测数据训一个代理模型。
三条路,成本差一个数量级。选哪条?看你的决策要多快、要多准。
💡 我的经验是:先问“孪生体要输出什么决策”,再倒推模型精度。如果只是报警“温度过高”,你连物理模型都不需要。
问:我们厂的设备数据质量很差,经常断点、跳变,还有大量手工录入。这种情况下还有必要做数字孪生吗?
答:先别做孪生,先做数据治理。这不是推脱,是省钱。孪生体的价值来自“可信”,输入是脏的,输出必然是错的——而且是那种看起来很像对的错,最危险。建议的路径是:先用三到六个月把关键设备的自动采集覆盖率提到 90% 以上,把手工录入项压缩到最少,把数据字典统一。这期间你不需要任何三维模型,只要一个能看趋势的看板就够了。等到数据稳定了,再做孪生,投入产出比会完全不同。反过来,带着一堆脏数据硬上孪生,大概率是项目验收时领导鼓掌,半年后无人登录。
三、虚拟调试,是目前最能算清 ROI 的场景
如果只让我推荐一个数字孪生的落地切口,我选虚拟调试(Virtual Commissioning)。
为什么?因为它省的是真金白银,而且省得可量化。
传统流程是这样:机械装完,电气接线,然后工程师抱着笔记本在现场一行行调 PLC 程序。产线停着,人在等着,一天几十号人的工时成本摆在那里。一条稍微复杂的装配线,现场调试干六到八周是常态。
虚拟调试把这一步提前了。机械还在图纸阶段,电气还没接线,PLC 程序已经在仿真环境里跑起来了。用 PLCSIM Advanced 配合 NX MCD 或者 Process Simulate,把信号映射表对齐,逻辑错误、干涉、节拍瓶颈,在电脑里就能撞出来。
我们做过的一个汽车零部件项目,现场调试从七周压到了两周半。省下来的时间,够他们多交付一个批次。✅
但这里有个特别不性感的活儿:信号映射表。
几千个 IO 点,一个一个对。变量名、地址、数据类型、量纲。做过的都知道有多烦。这个环节没做好,后面全是返工。所以我现在带项目,会把映射表当成一等公民,专人负责,版本管理,跟代码一样走变更流程。
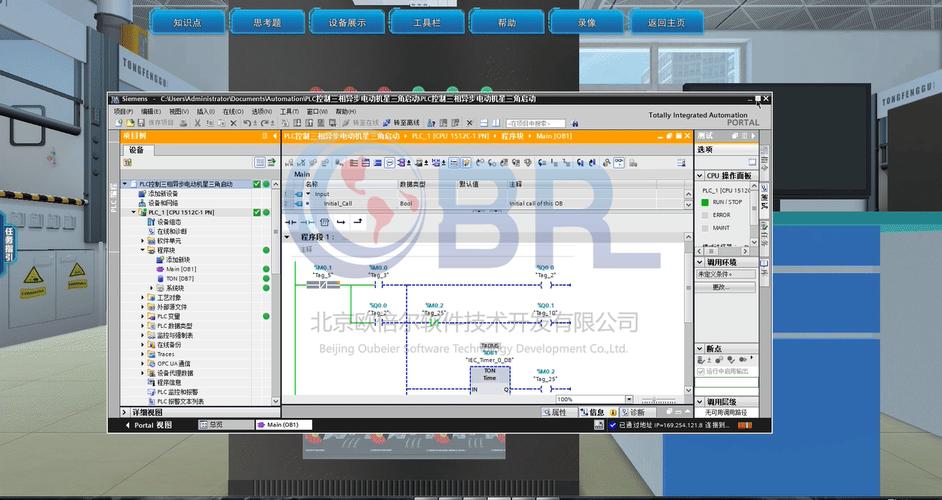 汽车零部件装配线虚拟调试PLC仿真软件界面截图
四、预测性维护:别一上来就上深度学习
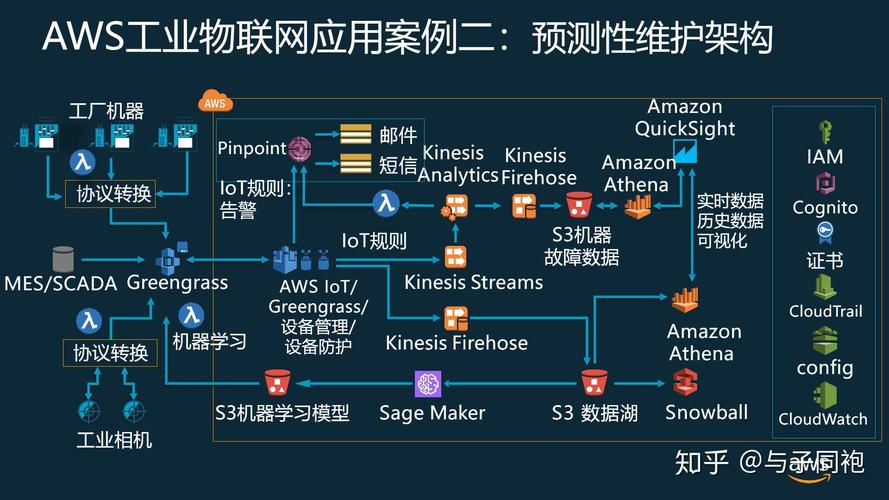 四、预测性维护:别一上来就上深度学习
这大概是数字孪生里被吹得最狠、翻车最多的方向。
我见过太多项目,上来就说要搞 LSTM、要搞 Transformer,要预测剩余寿命。结果呢?跑了一年,攒了几十条故障样本,模型训出来在测试集上 AUC 0.98,上线三个月一次没报准。
问题不在算法。在数据。
故障数据天生稀缺。设备好好的,谁去拆它?真坏了,往往也是直接换件,没人做失效分析。你手上就是没有标签。
所以我的建议顺序是这样的:
- 先做阈值报警加趋势预警。粗糙,但有效。轴承温度连续三小时缓慢上升,这个规律不需要神经网络也能看出来。
- 再上特征工程加传统模型。振动信号的时域特征(RMS、峭度、峰值因子)、频域特征(包络谱里的 BPFO、BPFI、BSF——外圈、内圈、滚动体故障特征频率)。这些是几十年的工业积淀,别丢。
- 最后才考虑深度模型,而且最好是物理信息神经网络 PINN 这类带机理约束的。纯黑箱在小样本上就是玄学。
❗另外提醒一句:传感器装在哪,比用什么算法重要十倍。测轴承故障,加速度计要尽量靠近轴承座,路径上少隔结合面。装错了位置,再好的模型也白搭。
问:数字孪生系统建成后,运维成本高吗?会不会变成一个没人维护的展示屏?
答:会。而且这是最常见的失败形态。原因通常有两个:一是模型和数据脱节,现场改了管路、换了电机,孪生体没同步,跑着跑着就成了“历史模型”;二是没有明确的使用者。谁每天打开它?如果答案是“领导视察的时候”,那它注定吃灰。我的建议是,从第一天起就把孪生体绑进某个岗位的日常工作流里——比如设备工程师的班前点检、工艺工程师的换型验证。有人每天用它做决策,它才活着。另外,模型版本管理要纳入 IT/OT 变更流程,跟图纸一样管,别当成一次性的交付物。
五、什么时候该做,什么时候劝你别碰
最后说点得罪人的话。
数字孪生不是标配。它有明确的适用边界。
值得做的信号:
- 停机损失大。一小时停线损失几十万的那种,值得投。
- 设备复杂、耦合强。单台设备好办,整线联动的瓶颈排查才是孪生的用武之地。
- 多品种小批量。换型频繁,虚拟验证能省下大量试错。
- 有历史数据积累。哪怕不完美,有总比没有强。
建议先放一放的信号:
- 单台几十万的老旧设备,坏了就修,停机不影响交付。
- 工艺流程还没定型,天天在改。你建完模型它就过时了。
- 团队里没人懂数据。买套软件,找家集成商,交付完就撤——这种项目活不过一年。
 智能工厂数字孪生三维实时监控大屏产线运行画面
说到底,数字孪生是个手段,不是目的。它解决的是信息不对称:让决策者在动手之前,知道会发生什么。
如果它没能让你少停一次机、少返一次工、少试错一轮,那它就只是一块屏幕。
而屏幕,到处都是。